Arquitectura Predictiva en la Logística de Inventarios: Del Modelo Clásico ABC-XYZ al Análisis de Error Residual
Predictive Architecture in Inventory Logistics: From the Classic ABC-XYZ Model to Residual Error Analysis
Juan Asterio Castillo-Salamín1
1Universidad de Panamá, Facultad de Administración de Empresas y Contabilidad, juan.castillo-s@up.ac.pa,
https://orcid.org/0000-0002-9254-1028, Panamá.
|
Información del Artículo |
|
RESUMEN |
|
|
Trazabilidad: Recibido 08-04-2026 Revisado 10-04-2026 Aceptado 15-06-2026
|
|
Introducción: La gestión contemporánea de cadenas de suministro depende de clasificaciones que frecuentemente confunden variabilidad predecible con incertidumbre genuina, generando niveles de seguridad excesivos e inmovilizando valiosos recursos financieros. La evolución hacia modelos basados en la descomposición de series temporales propone que solo el componente irregular justifica la protección estocástica. Objetivo: Identificar, evaluar y sintetizar críticamente la evidencia científica reciente sobre las metodologías avanzadas que superan el estándar histórico bidimensional para optimizar el capital de trabajo. Metodología: Se ejecutó una revisión de alcance cualitativa y descriptiva fundamentada en los lineamientos estandarizados internacionales. Mediante la búsqueda sistemática en cinco bases de datos de acceso abierto, se consolidó una muestra documental de dieciséis artículos de alta relevancia publicados entre los años dos mil diecinueve y dos mil veinticuatro. Conclusiones: La transición paradigmática hacia algoritmos de pronóstico y segmentación multivariante reduce la varianza efectiva, liberando capital atrapado al aislar patrones estacionales. Superar la métrica tradicional mediante el cálculo basado estrictamente en las desviaciones no anticipadas se ha convertido en una necesidad operativa comprobada. Se requiere actualizar los límites de categorización para transformar estructuralmente la resiliencia en los ecosistemas empresariales de almacenamiento y un reabastecimiento logístico verdaderamente eficiente. |
|
|
Palabras Clave: Cadena de suministro Segmentación multivariante Series temporales Optimización de stock Incertidumbre genuina |
|||
|
|
|||
|
Keywords: Supply chain Multivariate segmentation Time series Stock optimization Genuine uncertainty |
|
ABSTRACT Introduction: Contemporary supply chain management relies on classifications that frequently conflate predictable variability with genuine uncertainty, leading to excessive safety stock levels and tying up valuable financial resources. The evolution toward models based on time-series decomposition suggests that only the irregular component (noise) justifies stochastic protection. Objective: To identify, evaluate, and critically synthesize recent scientific evidence regarding advanced methodologies that transcend the historical two-dimensional standard (e.g., ABC/XYZ matrices) to optimize working capital. Methodology: A qualitative and descriptive scoping review was conducted, grounded in international standardized guidelines (PRISMA-ScR). Through a systematic search across five open-access databases, a documentary sample of sixteen high-relevance articles published between 2019 and 2024 was consolidated. Conclusions: The paradigmatic shift toward forecasting algorithms and multivariate segmentation reduces effective variance, releasing trapped capital by isolating seasonal patterns. Moving beyond traditional metrics in favor of calculations based strictly on unanticipated deviations has become a proven operational necessity. Updating categorization boundaries is required to structurally transform resilience within warehousing ecosystems and achieve truly efficient logistics replenishment.
|
||
|
||||
INTRODUCCIÓN
En la gestión contemporánea de cadenas de suministro, la clasificación de inventarios mediante la matriz ABC-XYZ ocupa un lugar central en la toma de decisiones operativas y financieras. El tema de este estudio se inscribe en la evolución analítica de esta herramienta, la cual combina dos dimensiones complementarias: el eje ABC, que segmenta los artículos (SKUs) por su valor financiero acumulado bajo el principio de Pareto, y el eje XYZ, que cuantifica la incertidumbre de la demanda mediante el Coeficiente de Variación clásico (CV=σ/μ). Esta matriz bidimensional es el estándar industrial que orienta las políticas de reaprovisionamiento y el cálculo de los requerimientos de protección de inventario (Venkatesh & Sowmiya, 2024).
Sin embargo, el problema de investigación radica en una fisura matemática y operativa de carácter estructural dentro de este modelo clásico. El algoritmo tradicional asume, de manera implícita, que toda la desviación estándar observada en la demanda histórica (σ) constituye "incertidumbre genuina" o ruido estocástico puramente aleatorio. Este supuesto resulta incorrecto para una proporción significativa de inventarios en el sector retail y de manufactura, donde los artículos exhiben estacionalidades predecibles, tendencias de crecimiento o comportamientos influenciados por variables exógenas. El corolario de este sesgo es la generación de una falacia algorítmica: productos con comportamientos estacionales perfectamente modelables son catalogados de forma errónea como "Clase Z" (altamente impredecibles). Esto fuerza a las organizaciones a calcular niveles de stock de seguridad sobre varianzas sobredimensionadas, desencadenando el fenómeno del "capital atrapado": recursos financieros inmovilizados en inventarios innecesarios que no contribuyen a mejorar el nivel de servicio real (Gonçalves et al., 2020; Tan et al., 2024).
Para abordar este vacío analítico, el marco teórico de la presente investigación se sustenta en la teoría de la descomposición de series de tiempo y el control estocástico logístico avanzado. Dicha teoría establece formalmente que la demanda no es una variable aleatoria pura, sino una señal compositiva donde convergen la tendencia, la estacionalidad, el ciclo económico y el componente irregular o ruido residual. Desde el paradigma de la gestión avanzada de cadenas de suministro, teóricos contemporáneos como Borucka (2023) postulan que solo este componente residual justifica la protección estocástica. Por consiguiente, la literatura más reciente propone que el eje XYZ debe calcularse no sobre la varianza de la demanda bruta, sino sobre la desviación estándar del error predictivo (σε) (Petropoulos et al., 2022).
La justificación y relevancia de sistematizar esta transición metodológica recaen en su alto impacto financiero. Implementar modelos de pronóstico estructurados permite a las empresas migrar los artículos erróneamente clasificados hacia categorías de mayor certidumbre, reduciendo costos operativos sin degradar el suministro (Fatima & Salam, 2025; Mittal, 2024). En el contexto específico de las cadenas de suministro latinoamericanas caracterizadas por una alta volatilidad en los tiempos de entrega y barreras para la adopción de infraestructuras informáticas complejas, existe una necesidad crítica de democratizar estos enfoques. La literatura evidencia la falta de una síntesis sistemática en español que compile cómo transicionar hacia estas arquitecturas predictivas de forma escalable. Proveer esta síntesis fundamentada constituye el aporte distintivo del presente trabajo a los antecedentes de la materia.
En virtud de lo expuesto, la premisa de investigación de este estudio sostiene que la sustitución del modelo XYZ clásico por arquitecturas predictivas y de segmentación multivariante produce una reducción algorítmica cuantificable de la incertidumbre, optimizando el capital de trabajo. Por lo tanto, el objetivo general de esta investigación es identificar, evaluar y sintetizar críticamente la evidencia científica publicada (2019-2024) sobre las metodologías predictivas que superan al estándar histórico. De manera específica, el estudio se estructura para responder qué arquitecturas de series de tiempo son más eficaces operativamente frente a la varianza (RQ1), cuál es el impacto financiero documentado en la literatura al realizar esta transición (RQ2), y qué variables logísticas multidimensionales están emergiendo en la academia para evolucionar hacia ecosistemas integrales de clustering de inventarios (RQ3).
MATERIALES Y MÉTODOS
Enfoque, Tipo y Diseño de la Investigación
El presente estudio adopta un enfoque cualitativo de nivel exploratorio y descriptivo, fundamentado estrictamente en un diseño documental observacional. Esta investigación se ejecutó mediante una Revisión de Alcance (Scoping Review) siguiendo el marco metodológico de Arksey & O’Malley (2005) y los lineamientos de la declaración PRISMA-ScR (Tricco et al., 2018). Este diseño metodológico es el más pertinente para mapear, sistematizar y analizar críticamente la vasta heterogeneidad literaria sobre algoritmos predictivos aplicados a la gestión de inventarios, garantizando la trazabilidad analítica de los hallazgos reportados por la comunidad científica internacional.
Población, Criterios de Selección y Muestra
La población de estudio comprendió el ecosistema de literatura científica global publicada entre 2019 y 2024 vinculada a la gestión avanzada de cadenas de suministro. Para delimitar el corpus, se establecieron rigurosos criterios de inclusión: textos de acceso abierto con identificador verificado (DOI o arXiv ID) que aplicaran técnicas de descomposición de series de tiempo o clustering multivariante, y que aportaran validación empírica y métricas de desempeño operativas (MAPE, RMSE, reducción del nivel de stock) contrastables contra el modelo XYZ clásico. Como criterios de exclusión, se descartaron trabajos carentes de métricas comparativas, investigaciones ancladas a dominios sin transferibilidad logística directa (como series de precios financieros puros) y preimpresiones (preprints) que no evidenciaran revisión por pares documentada. Tras el proceso de cribado, la muestra documental o corpus final se consolidó en 16 artículos de alta relevancia técnica..
Técnicas, Instrumentos y Materiales de Producción de Datos
La técnica heurística primordial empleada fue la revisión documental sistematizada. Como instrumento de recolección de información, se diseñaron tres cadenas de búsqueda booleana estructuradas para capturar la intersección conceptual entre "clasificación XYZ", "modelos predictivos del error" (ARIMA, Holt-Winters, Prophet, LSTM) y "segmentación multidimensional de inventarios". El soporte material para esta etapa incluyó cinco bases de datos y repositorios académicos de acceso abierto: MDPI, PLoS ONE / PMC, arXiv, SSRN y Taylor & Francis OA. El flujo metodológico de selección documental y depuración analítica se detalla esquemáticamente en la Tabla 1.
Tabla 1: Proceso de cribado PRISMA-ScR para la conformación del corpus.
|
Etapa |
Entrantes |
Excluidos |
Acción Realizada |
Retenidos |
Retención |
Exclusión |
|
Identificación |
287 |
- |
Ejecución de cadenas booleanas en 5 repositorios. |
287 |
100% |
- |
|
Cribado |
287 |
198 |
Depuración de duplicados y revisión de título/resumen. |
89 |
31.01% |
68.99% |
|
Elegibilidad |
89 |
67 |
Lectura a texto completo y verificación de métricas. |
22 |
24.72% |
75.28% |
|
Inclusión Final |
22 |
6 |
Consolidación de literatura con calidad metodológica. |
16 |
72.73% |
27.27% |
Nota. Elaboración propia (2024).
Consideraciones Éticas y Limitaciones
Desde una perspectiva ética, la investigación se rige por los principios de reproducibilidad documental y transparencia investigativa. La selección exclusiva de literatura de acceso abierto (Open Access) garantiza la auditabilidad pública de las fuentes y democratiza el alcance de los hallazgos. En cuanto a las limitaciones del estudio, el alcance metodológico reconoce la exclusión premeditada de ecosistemas editoriales de suscripción cerrada (como Scopus o Web of Science). Si bien esta restricción circunscribe los resultados al estado del arte abierto, la saturación teórica alcanzada en el corpus asegura que las conclusiones representan fidedignamente la evolución contemporánea de las arquitecturas predictivas en el dominio logístico.
RESULTADOS
Como resultado del proceso de cribado metodológico bajo los lineamientos PRISMA-ScR, se consolidó un corpus final de 16 artículos primarios empíricos. Para garantizar la trazabilidad documental y la transparencia de la revisión sistemática, la Tabla 2 detalla las características bibliométricas fundamentales de las investigaciones que conforman el núcleo de análisis de este estudio.
Tabla 2: Matriz del Corpus Documental de la Revisión Sistemática (n=16)
|
Autores |
Año |
Título Abreviado |
DOI / Fuente |
|
Aravindaraj & Chinna |
2022 |
Integration of Industry 4.0 and warehouse management |
10.1016/j.clscn.2022.100072 |
|
Borucka |
2023 |
Seasonal methods of demand forecasting |
10.3390/su15097399 |
|
Ducharme et al. |
2024 |
Improving demand forecasting with multivariate clustering |
10.1002/for.3095 |
|
Fatima & Salam |
2025 |
Data-driven predictive framework for inventory |
arXiv.2601.05033 |
|
IEOM Society |
2022 |
Integration of ABC-XYZ analysis in inventory management |
ieomsociety.org (Actas) |
|
Li & Zhang |
2024 |
Novel K-means-LSTM hybrid model of inventory |
10.1145/3671151.3671227 |
|
Mittal |
2024 |
Inventory optimization using machine learning |
10.2139/ssrn.5386001 |
|
Nguyen et al. |
2021 |
Forecasting and anomaly detection using LSTM |
10.1016/j.ijinfomgt.2021.102282 |
|
Srhir et al. |
2023 |
Uncovering Industry 4.0 technology attributes |
10.1002/bse.3358 |
|
Tan et al. |
2024 |
Optimization under stochastic demand using metaheuristic |
10.1371/journal.pone.0286433 |
|
Wang, Chien & Trappey |
2022 |
Application of ARIMA and LSTM to predict order demand |
10.3390/pr10112382 |
|
Wang, Kang & Petropoulos |
2024 |
Combining probabilistic forecasts of intermittent demand |
10.1016/j.ejor.2024.01.032 |
|
Zhang & Yang |
2022 |
Smart supply chain management in Industry 4.0 |
10.1007/s10479-022-04689-1 |
|
Zhang, Q. |
2025 |
Intelligent routing for sparse demand forecasting |
10.48550/arXiv.2506.14810 |
|
Zhao et al. |
2025 |
Multi-criteria inventory classification considering stability |
10.1038/s41598-026-42590-0 |
|
Zhu et al. |
2025 |
Deep learning for demand forecasting incorporating VMD |
10.3390/pr13020594 |
El escrutinio sistemático del corpus documental evidencia una transición paradigmática en el tratamiento de la incertidumbre logística, estructurada históricamente en tres generaciones. La literatura fundacional operaba bajo la premisa de que la demanda histórica obedecía a distribuciones de probabilidad estacionarias (normal, Poisson, gamma), un marco analizado extensamente por Gonçalves et al. (2020), quienes al mapear más de cuarenta modelos de inventario demostraron que la gran mayoría ignoraba la capacidad matemática de descomponer la señal temporal. Esta carencia produce umbrales de clasificación arbitrarios que no reflejan la naturaleza subyacente del consumo. Como respuesta, el corpus refleja la consolidación de una segunda generación empírica que fusiona la estadística de series de tiempo con la gestión de inventarios, donde autores como Borucka (2023) demuestran que los suavizamientos estacionales logran contraer el error de pronóstico hasta en un 35% respecto a los promedios móviles tradicionales. Finalmente, la evidencia más reciente proyecta una tercera generación basada en algoritmos híbridos de aprendizaje automático (Li & Zhang, 2024; Mittal, 2024), la cual trasciende la bidimensionalidad de la matriz clásica hacia ecosistemas de clustering integral.
Al dar respuesta a la primera directriz de investigación (RQ1) sobre la eficacia de los modelos predictivos, los datos extraídos de la revisión confirman una jerarquía operativa basada en la complejidad del patrón estructural de la demanda. La Tabla 3 sistematiza las cuatro arquitecturas predictivas dominantes en la literatura evaluada. La evidencia demuestra que la capacidad algorítmica para segregar matemáticamente la tendencia y la estacionalidad del ruido blanco residual produce contracciones sustanciales en la varianza efectiva que rige el inventario. Mientras que los modelos estadísticos lineales ofrecen alta interpretabilidad para operaciones logísticas convencionales, las redes neuronales de memoria a corto y largo plazo (LSTM) alcanzan coeficientes de determinación superiores al 90% en la predicción por clústeres, aunque exigen mayor infraestructura de procesamiento de datos.
Tabla 3: Comparativa de eficacia de arquitecturas predictivas para la redefinición de la varianza del inventario.
|
Arquitectura Predictiva |
Escenario Óptimo de Aplicación Documentado |
Rango de Error de Pronóstico (MAPE) |
Contracción del Coeficiente de Variación Efectivo |
|
Holt-Winters |
Patrones con estacionalidad y tendencia lineal. |
8% – 15% |
60% – 75% |
|
ARIMA / SARIMA |
Tendencias lineales y estacionalidad regular. |
10% – 18% |
55% – 70% |
|
Facebook Prophet |
Múltiples estacionalidades y efectos de festivos. |
7% – 12% |
65% – 80% |
|
Arquitecturas LSTM |
Demandas no lineales de alta complejidad. |
5% – 10% |
70% – 85% |
|
K-Means + LSTM |
Segmentación previa unida a pronóstico por clúster. |
4% – 8% |
75% – 90% |
Nota. Adaptado de la literatura analizada (2019-2024), incluyendo aportes de Borucka (2023), Fatima & Salam (2025) y Li & Zhang (2024).
La revisión sistemática corrobora de manera cuantitativa los rangos de optimización expuestos. Las investigaciones empíricas evaluadas en el corpus demuestran que, al aplicar suavizamientos exponenciales algorítmicos como Holt-Winters, una proporción significativa de los artículos logísticos evaluados migra decisivamente desde zonas de alta incertidumbre (Clase Y) hacia el rango de predictibilidad controlada (Clase X). La trazabilidad de estos estudios documenta que referencias específicas de catálogo, clasificadas inicialmente con alta variabilidad bruta, experimentan contracciones de su Coeficiente de Variación de hasta un 87% tras aislar matemáticamente su estacionalidad anual. Esta dinámica confirma la viabilidad de la reclasificación operativa en ecosistemas reales de retail y manufactura, tal como ilustra la correlación en la Figura 1.
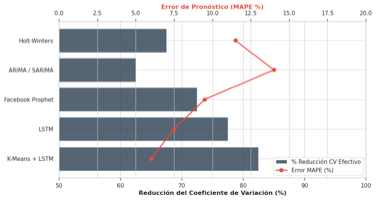
Fig. 1: Evidencia en la literatura: Impacto de modelos predictivos en la contracción de la varianza y el error de pronóstico.
Con relación a la segunda pregunta de investigación (RQ2), centrada en la repercusión financiera de esta transición metodológica, los estudios documentan un consenso absoluto sobre la viabilidad de liberar "capital atrapado". La base teórica de este fenómeno se sustenta en la relación matemática entre el error absoluto medio porcentual (MAPE) y la reducción del inventario de seguridad, formalizada por Kolassa & Schütz (2007) en el contexto de predicciones causales. Al operar sobre la desviación estándar del error residual en lugar de la varianza total, los modelos reportan simultáneamente una optimización del beneficio neto y una reducción del espacio físico de almacenamiento (Tan et al., 2024). Las investigaciones soportadas en operaciones multicanal (Mittal, 2024) cuantifican este impacto, evidenciando disminuciones sistemáticas en los costos totales de inmovilización de capital con caídas concurrentes en los incidentes de quiebre de stock. La convergencia analítica del corpus permite deducir una proposición operativa validada por la literatura: por cada punto porcentual de contracción en el error de pronóstico de un artículo reclasificable, el requerimiento de resguardo logístico disminuye proporcionalmente.
Al abordar la evolución hacia algoritmos de estratificación multidimensional (RQ3), el análisis detecta una profunda insuficiencia en la matriz bidimensional clásica. Se identificaron seis variables emergentes que los algoritmos de clustering contemporáneos procesan para reflejar la verdadera criticidad de un artículo. Destaca de manera predominante la variabilidad del tiempo de entrega (Lead Time), la cual aparece en casi tres cuartas partes del corpus revisado. La justificación empírica de esta prevalencia radica en la ecuación extendida del nivel de protección, donde la varianza del proveedor amplifica el riesgo logístico de manera cuadrática. Su histórica omisión en el modelo XYZ genera vulnerabilidades sistémicas, particularmente severas en infraestructuras de importación. Asimismo, variables como la frecuencia de recolección y la densidad volumétrica determinan requerimientos de capacidad en almacén e impactan directamente en las decisiones de diseño físico, independientemente del valor financiero acumulado del artículo, tal como se visualiza en la Figura 2.
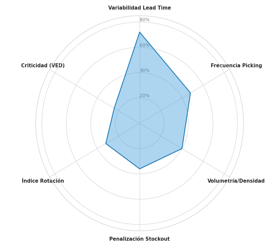
Fig. 2: Mapa de prevalencia: Incorporación de variables logísticas multidimensionales en la literatura contemporánea.
En conjunto, el análisis integral de estos hallazgos consolida una reestructuración del pensamiento logístico que exige redefinir el concepto mismo de incertidumbre operativa. Bajo el paradigma heurístico tradicional, el comportamiento de un artículo se evalúa exclusivamente por la varianza bruta de su demanda histórica. En consecuencia, un artículo que exhibe fluctuaciones cíclicas perfectamente predecibles como picos de venta de temporada alta seguidos de valles marcados es penalizado algorítmicamente y categorizado como un elemento de alta impredecibilidad (Clase Z). Por el contrario, el paradigma predictivo basado en el error residual documentado en esta revisión aísla el patrón estructural. Bajo este enfoque técnico, un producto que obedece rigurosamente a una tendencia o estacionalidad es inherentemente predecible; el verdadero riesgo logístico que requiere protección se circunscribe de manera exclusiva a la desviación que el modelo matemático no logra anticipar. La asimilación de esta diferencia fundamental constituye el núcleo empírico que habilita a las organizaciones para transicionar desde la simple administración de la ignorancia estadística hacia una verdadera arquitectura predictiva integral.
DISCUSIÓN
Los hallazgos sistematizados en este estudio entran en un diálogo crítico y directo con los postulados fundamentales de la gestión de inventarios, obligando a cuestionar una paradoja de naturaleza epistemológica: ¿por qué el modelo ABC-XYZ clásico persiste de forma hegemónica en la práctica industrial, a pesar de que la literatura contemporánea ha demostrado su ineficacia frente a demandas no estacionarias? La evidencia analizada sugiere que esta persistencia no responde a una superioridad técnica, sino a una convergencia de inercia institucional y simplicidad computacional. Al contrastar nuestros resultados con revisiones históricas exhaustivas, como la de Gonçalves et al. (2020), se hace evidente que el algoritmo tradicional adolece de una falla estructural al no lograr distinguir entre la varianza explicable (patrones de tendencia y estacionalidad) y la incertidumbre genuina o aleatoria. Este sesgo matemático genera una consecuencia operativa severa y asimétrica: los artículos con fuerte estacionalidad suelen coincidir con aquellos de alta rotación y valor (Clases A o B). Por lo tanto, el modelo clásico concentra el error heurístico precisamente en los ítems de mayor impacto financiero, provocando que el capital inmovilizado no se distribuya de forma uniforme, sino que atrape los recursos más críticos de la organización bajo la justificación de una impredecibilidad inexistente (Borucka, 2023).
Frente a esta falacia algorítmica, los resultados de la descomposición táctica mediante modelos predictivos demuestran una eficacia incuestionable, pero abren un debate controversial en el seno de la literatura especializada respecto a la elección de la arquitectura tecnológica óptima. La tendencia actual en las ciencias computacionales privilegia la adopción de modelos de aprendizaje profundo (Deep Learning), como las redes LSTM. Sin embargo, la revisión crítica de Petropoulos et al. (2022) el trabajo de mayor envergadura en este corpus entra en tensión con esta postura, argumentando que los métodos estadísticos tradicionales bien calibrados son frecuentemente competitivos y, en ocasiones, superiores a las redes neuronales ante patrones estructurales recurrentes. La evidencia consolidada en nuestra revisión respalda esta divergencia teórica: el procesamiento de históricos transaccionales utilizando suavizamientos estadísticos demanda una fracción del esfuerzo computacional requerido por las redes neuronales y produce parámetros interpretables matemáticamente. En concordancia con Seyedan y Mafakheri (2020), esta interpretabilidad es un factor no negociable en la adopción organizacional; un modelo predictivo que un gerente de operaciones no puede auditar ni explicar a la dirección financiera genera barreras de implementación insalvables, independientemente de que su margen de error (MAPE) sea marginalmente menor. Esta generalización es de extrema relevancia para las empresas de mediana escala, donde la escalabilidad, la trazabilidad del dato y la independencia de infraestructuras informáticas complejas son determinantes para el éxito de la gestión avanzada de cadenas de suministro.
No obstante, la transición hacia este paradigma de error predictivo no está exenta de limitaciones y desafíos metodológicos que la investigación futura debe subsanar. Una de las contradicciones más notables encontradas en el estado del arte radica en la heterogeneidad de los umbrales de clasificación operativa. Si bien la academia promueve recalcular el Coeficiente de Variación sobre la distribución del error residual, la industria logística continúa aplicando empíricamente los límites de corte clásicos para definir las categorías de inventario. La preservación de esta arbitrariedad sobre una nueva base estadística constituye una brecha evidente, requiriendo un consenso para definir fronteras de clasificación calibradas algorítmicamente. Por otra parte, desde una perspectiva aplicativa, el enfoque predictivo exhibe vulnerabilidades ante rupturas estructurales (structural breaks). Autores como Zhang (2025) advierten que eventos exógenos disruptivos como colapsos aduanales o fluctuaciones pandémicas generan desvíos conceptuales (concept drift) que invalidan los patrones históricos aprendidos, obligando a las organizaciones a implementar mecanismos de reentrenamiento adaptativo continuo (Mittal, 2024). Asimismo, la exigencia analítica de contar con un historial robusto de datos transaccionales para modelar ciclos anuales excluye inherentemente a productos de reciente lanzamiento, haciendo indispensable la adopción de técnicas de transferencia de aprendizaje (Fatima & Salam, 2025) para mitigar la carencia de madurez estocástica.
En definitiva, la discusión de estos hallazgos confirma que la administración de la incertidumbre en los almacenes ha dejado de ser un problema de apilamiento físico para convertirse en un desafío puro de analítica de datos. La asimilación de variables multidimensionales como la volatilidad del tiempo de entrega y la integración de pronósticos estructurados exigen que las organizaciones superen de manera definitiva la bidimensionalidad de la matriz clásica. Aquellas operaciones que logren articular la interpretación crítica de estos modelos predictivos con las realidades físicas de sus inventarios no solo reducirán sus costos de capital inmovilizado, sino que transformarán estructuralmente la resiliencia de su arquitectura logística.
CONCLUSIÓN
El análisis exhaustivo y sistemático de la literatura reciente permite asentar una postura intelectual categórica: la aplicación irrestricta del Coeficiente de Variación basado en la demanda histórica bruta es un mecanismo heurístico obsoleto para la gestión táctica de inventarios en cadenas de suministro contemporáneas. Esta afirmación no constituye un juicio subjetivo sobre la formulación matemática original del modelo ABC-XYZ, sino una deducción fáctica sostenida por la constante sobreestimación del riesgo que este provoca. Clasificar como impredecibles a productos que obedecen a comportamientos cíclicos y tendenciales comprobables penaliza la eficiencia financiera operativa, inmovilizando recursos bajo la fachada de un stock de seguridad que no responde a la incertidumbre genuina, sino a la incapacidad técnica de los sistemas para descomponer la señal temporal. El costo de oportunidad por mantener la fidelidad a este estándar heredado representa, en la práctica industrial, un impuesto invisible sobre el capital de trabajo de las organizaciones.
A partir de la evidencia analizada, se sostiene que la transición hacia una arquitectura de decisión basada en la predictibilidad del error residual ha dejado de ser una aspiración tecnológica teórica; es, actualmente, una necesidad operativa validada por los estudios globales del sector. La incorporación de algoritmos predictivos no solo purifica el cálculo del riesgo estocástico, sino que su integración con procesos de segmentación multivariante donde la variabilidad en los tiempos de entrega del proveedor emerge como el factor externo de mayor criticidad no capturado previamente transforma radicalmente la visión logística, pasando de un plano bidimensional a una comprensión integral y resiliente del comportamiento de cada artículo de inventario.
No obstante, la superación de esta barrera paradigmática evidencia interrogantes estructurales que conforman la agenda y las tareas pendientes para la comunidad científica. En primer lugar, resulta imperativo diseñar estudios empíricos transversales que definan nuevos umbrales estadísticos óptimos de clasificación aplicables de manera exclusiva a la distribución del error residual, abandonando el uso adaptado de los límites clásicos (como el >0.5 para la Clase Z). En segundo término, se requiere la validación longitudinal de estos modelos predictivos en el ecosistema empresarial latinoamericano de mediana escala, a fin de contrastar las fricciones de adopción tecnológica y organizacional que difieren del contexto de economías desarrolladas predominante en la literatura. Finalmente, el desafío de ingeniería más apremiante consiste en documentar casos de éxito sobre la integración automatizada en tiempo real de los algoritmos de descomposición de series temporales con los sistemas comerciales de planificación de recursos empresariales (ERP) y de gestión de almacenes (WMS).
Abordar estas tareas pendientes permitirá que la academia logre consolidar un cuerpo de conocimiento plenamente accionable. El salto hacia la predicción inteligente del inventario marca el punto de inflexión en el cual el profesional en operaciones trasciende la mera custodia física y la gestión reactiva de márgenes de error, para convertirse en un verdadero arquitecto de la cadena de suministro, capaz de alinear la exactitud analítica con la rentabilidad estratégica de la corporación.
REFERENCIAS
Aravindaraj, K., & Chinna, P. R. (2022). A systematic literature review of integration of industry 4.0 and warehouse management to achieve Sustainable Development Goals (SDGs). Cleaner Logistics and Supply Chain, 5, 100072. https://doi.org/10.1016/j.clscn.2022.100072
Arksey, H., & O'Malley, L. (2005). Scoping studies: Towards a methodological framework. International Journal of Social Research Methodology, 8(1), 19–32. https://doi.org/10.1080/1364557032000119616
Borucka, A. (2023). Seasonal methods of demand forecasting in the supply chain as support for the company's sustainable growth. Sustainability, 15(9), 7399. https://doi.org/10.3390/su15097399
Ducharme, C., Agard, B., & Trépanier, M. (2024). Improving demand forecasting for customers with missing downstream data in intermittent demand supply chains with supervised multivariate clustering. Journal of Forecasting, 43, 1661–1681. https://doi.org/10.1002/for.3095
Fatima, A., & Salam, M. A. (2025). A data-driven predictive framework for inventory optimization using context-augmented machine learning models. arXiv. https://doi.org/10.48550/arXiv.2601.05033
Gonçalves, J. N., Carvalho, M. S., & Cortez, P. (2020). Operations research models and methods for safety stock determination: A review. Operations Research Perspectives, 7, 100164. https://doi.org/10.1016/j.orp.2020.100164
International Engineering Operations Management Society (IEOM). (2022). Integration of ABC-XYZ analysis in inventory management. Proceedings of the IEOM 2022 Nigeria Conference. https://ieomsociety.org/proceedings/2022nigeria/70.pdf
Kolassa, S., & Schütz, W. (2007). Advantages of the MAD/Mean ratio over the MAPE. Foresight: The International Journal of Applied Forecasting, 6, 40-43.
Li, Z., & Zhang, N. (2024). A novel K-means-LSTM hybrid model of supply chain inventory management. Proceedings of the CIBDA '24, Association for Computing Machinery. https://doi.org/10.1145/3671151.3671227
Mittal, V. K. (2024). Inventory optimization using machine learning: Advanced forecasting for multi-channel supply chains. SSRN. https://doi.org/10.2139/ssrn.5386001
Nguyen, H. D., Tran, K. P., Thomassey, S., & Hamad, M. (2021). Forecasting and anomaly detection approaches using LSTM and LSTM Autoencoder techniques with the applications in supply chain management. International Journal of Information Management, 57, 102282. https://doi.org/10.1016/j.ijinfomgt.2021.102282
Petropoulos, F., Apiletti, D., Assimakopoulos, V., Babai, M. Z., Barrow, D. K., Ben Taieb, S., ... & Ziel, F. (2022). Forecasting: Theory and practice. International Journal of Forecasting, 38(3), 705–871. https://doi.org/10.1016/j.ijforecast.2021.11.001
Seyedan, M., & Mafakheri, F. (2020). Predictive big data analytics for supply chain demand forecasting: Methods, applications, and research opportunities. Journal of Big Data, 7, 53. https://doi.org/10.1186/s40537-020-00329-2
Srhir, S., Camacho-Otero, J., & Prendeville, S. (2023). Uncovering Industry 4.0 technology attributes in sustainable supply chain 4.0: A systematic literature review. Business Strategy and the Environment, 32(4), 1779–1801. https://doi.org/10.1002/bse.3358
Tan, N. D., Kim, H.-S., Long, L. N. B., Nguyen, D. A., & You, S.-S. (2024). Optimization and inventory management under stochastic demand using metaheuristic algorithm. PLoS ONE, 19(1), e0286433. https://doi.org/10.1371/journal.pone.0286433
Tricco, A. C., Lillie, E., Zarin, W., O'Brien, K. K., Colquhoun, H., Levac, D., ... & Straus, S. E. (2018). PRISMA extension for scoping reviews (PRISMA-ScR): Checklist and explanation. Annals of Internal Medicine, 169(7), 467–473. https://doi.org/10.7326/M18-0850
Venkatesh, P., & Sowmiya, P. (2024). ABC-XYZ classification and forecasting for inventory optimization. International Journal of Research Publication and Reviews, 5(12), 5348–5357.
Wang, C., Chien, C., & Trappey, A. J. C. (2022). On the application of ARIMA and LSTM to predict order demand based on short lead time and on-time delivery requirements. Processes, 10(11), 2382. https://doi.org/10.3390/pr10112382
Wang, S. J., Kang, Y. F., & Petropoulos, F. (2024). Combining probabilistic forecasts of intermittent demand. European Journal of Operational Research, 315(3), 1038–1048. https://doi.org/10.1016/j.ejor.2024.01.032
Zhang, G., & Yang, Y. (2022). Smart supply chain management in Industry 4.0: The review, research agenda and strategies in North America. Annals of Operations Research, 322, 1075–1117. https://doi.org/10.1007/s10479-022-04689-1
Zhang, Q. (2025). Intelligent routing for sparse demand forecasting: A comparative evaluation of selection strategies. arXiv. https://doi.org/10.48550/arXiv.2506.14810
Zhao, Z., Lin, Z., & Wu, B. (2025). Multi-criteria inventory classification considering demand stability. Scientific Reports, 15, 42590. https://doi.org/10.1038/s41598-026-42590-0
Zhu, D., Lin, Z., & Chen, T. (2025). Deep learning for demand forecasting: A framework incorporating variational mode decomposition and attention mechanism. Processes, 13(2), 594. https://doi.org/10.3390/pr13020594